2026년 7월 15일 아마존웹서비스(AWS)는 CloudWatch Logs에 지능형 저장 계층화 기능을 추가했다. CloudWatch Logs는 애플리케이션이나 시스템이 남긴 기록을 수집하고 조사하는 데 쓰인다. 새 기능의 대상은 그곳에 저장한 데이터다. AWS는 조회 이력을 관찰해 표준, 저빈도 접근, 즉시 접근 아카이브의 세 저장 계층에 자동으로 배치하겠다고 밝혔다. 이 구조는 오래 묵은 로그를 계속 같은 서비스에서 찾으면서 저장비를 줄이려는 고객을 겨냥했다.[1]
마지막으로 읽은 때가 저장 위치를 가른다
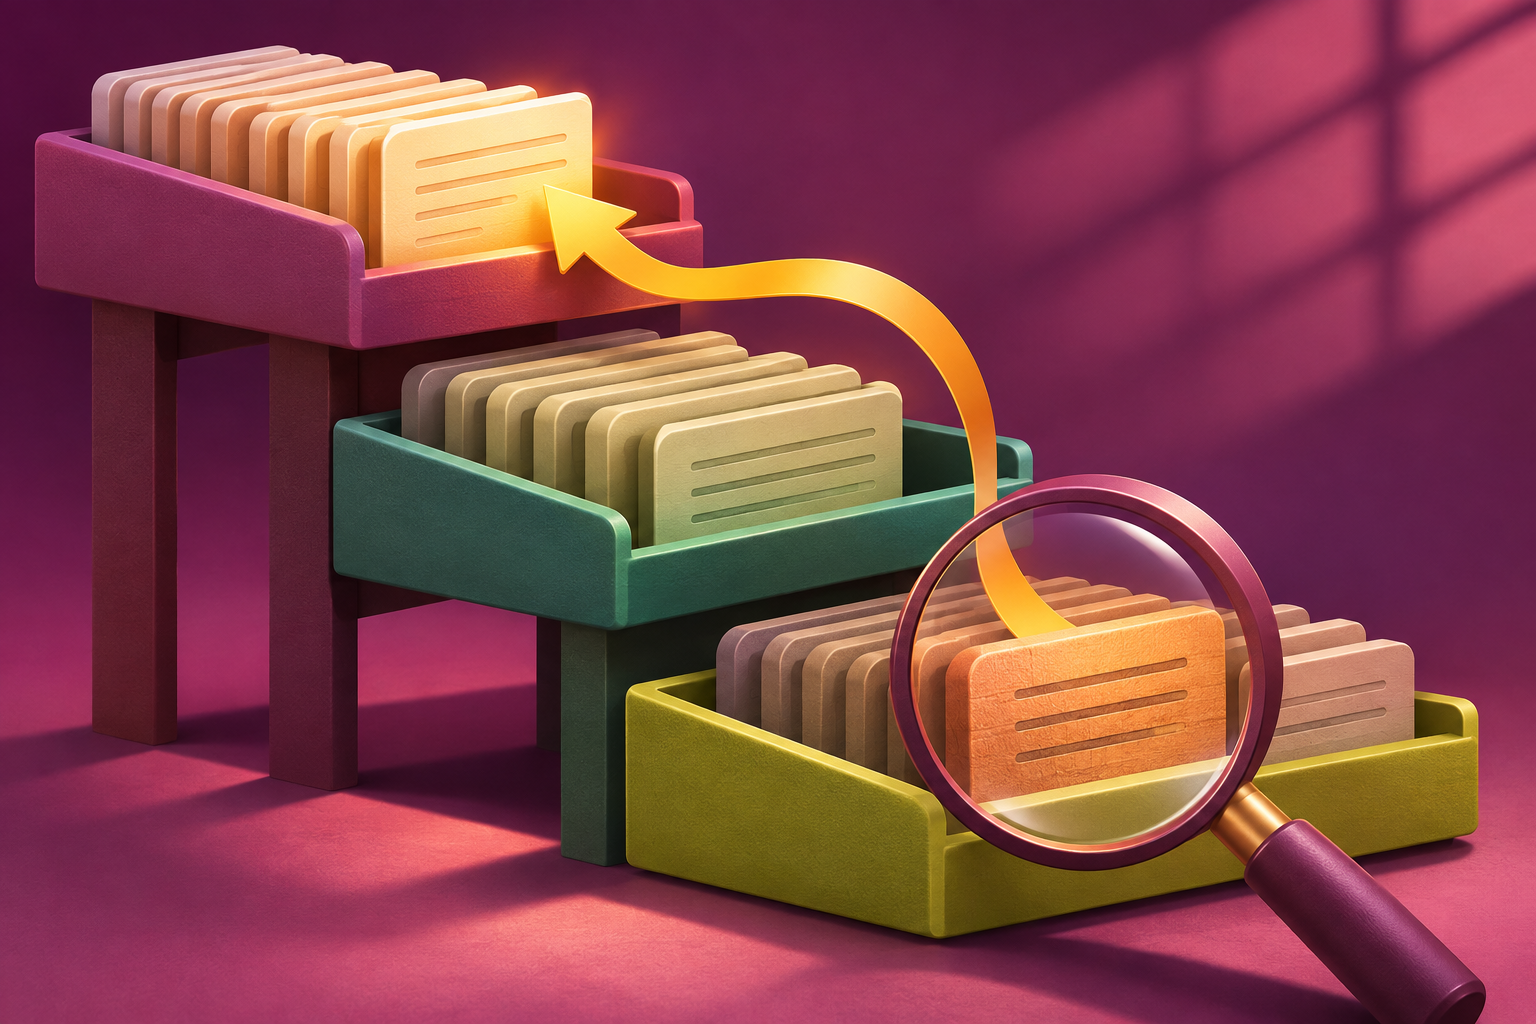
저장 계층을 바꾸는 조건은 데이터가 오래됐는지와 실제로 최근 읽었는지를 함께 고려해 이해할 수 있다. AWS의 출시 안내는 30일 동안 조회하지 않은 데이터를 저빈도 접근 계층으로 재분류하고 90일 동안 조회하지 않은 데이터는 즉시 접근 아카이브로 옮긴다고 설명한다. 묵혀 둔 데이터를 조회하면 표준 계층으로 올라가 30일 동안 유지된다. 발표에 따르면 사용자는 로그가 들어 있는 계층에 따라 다른 화면에서 검색할 필요 없이 동일한 조회 흐름을 이어갈 수 있다.[1]
가령 시스템 개편을 마친 지 넉 달이 된 운영팀이 새 버전의 문제가 예전에도 있었는지 조사한다고 하자. 평소에는 개편 이전 기록을 읽지 않지만 특정 오류가 발생하면 당시 기록을 다시 검색한다. 조회가 없었던 동안에는 해당 데이터가 자동 분류 기준에 맞춰 낮은 비용의 계층에 있을 수 있다. 이번 조사에서 접근했다면 읽은 데이터가 표준 계층으로 옮겨진다는 점을 저장비에 반영해야 한다. 특정 계정의 요금을 계산한 예는 아니며, 같은 연령의 데이터도 최근 접근 이력에 따라 저장 계층이 달라질 수 있음을 보여 준다.[1]
고정 클래스와 자동 저장 계층의 차이
동일한 CloudWatch Logs에 데이터를 둔다는 기준에서 2023년 저빈도 접근 로그 클래스와 2026년의 자동 저장 계층 기능을 비교할 수 있다. 2023년 AWS가 발표한 옵션은 로그 그룹을 저빈도 사용 사례에 맞는 클래스로 만드는 방식이었다. 일부 기능만 제공하는 조건으로 수집 비용을 낮추고 조회를 지원하는 구조로 소개됐다. 2026년 7월 발표는 저장된 데이터의 최근 접근 패턴을 보고 서비스가 저장 계층을 재분류하는 기능이다. 과거 로그 클래스의 수집비 절감과 이번 기능의 저장비 절감을 같은 비용 항목으로 간주하면 비교가 틀어진다.[1][2]
기존 로그 그룹이 어떤 클래스인지 확인하는 이유도 여기에 있다. 로그 그룹에서 이용 가능한 기능을 따지는 것과 데이터가 어느 저장 계층에 남아 있을지 따지는 것이 서로 다른 질문이기 때문이다. 가령 로그를 수집할 때마다 비용이 발생하는 환경에서 기록량이 갑자기 늘면, 자동 계층화만으로 수집 증가분이 모두 상쇄될지 알 수 없다. 기존 클래스 설명에 포함된 기능 범위와 새 서비스가 다루는 저장 범위를 각각 확인할 때 비용을 맞춰 비교할 수 있다.[1][2]
보존기간이 길수록 이력 확인이 중요하다
로그를 보존할 기간을 정하는 것과 보관 중인 데이터를 어떤 저장 계층에 둘지 정하는 것은 별개의 설정이다. 지난 분기 기록을 20일 뒤에 지우는 운영 방식이라면 30일 동안 접근하지 않은 데이터가 쌓일 여지가 작다. 반대로 여러 달 동안 기록을 보존하면서 사고가 드물게 발생하는 환경이라면 저빈도 접근과 즉시 접근 아카이브의 조건을 충족하는 데이터가 생길 수 있다. 같은 양의 로그를 수집해도 조회 분포와 보존기간에 따라 저장 비용이 달라지는 이유다.[1]
운영자가 구체적으로 추적할 수 있는 것은 하루에 들어오는 양, 얼마 동안 삭제하지 않는지, 조사할 때 어떤 시점에 생성된 로그를 반복해서 읽는지다. 장애 대응에 성공했는지 살필 때에는 이전에 파일을 다른 저장소에서 꺼내야 했던 횟수와 같은 흐름에서도 검색 가능한지 확인할 수 있다. 서비스가 세 계층을 자동으로 선택해도 어떤 로그와 기간을 조회할지는 계속 업무 요건에 달려 있다. 기존 클래스도 사용 사례에 맞춰 선택하도록 만들어졌으며, 이름이 비슷한 옵션은 절감되는 비용 항목부터 비교할 수 있다.[1][2]
발표만으로 절감률을 정할 수 없다
출시 안내만으로는 개별 조직이 절약할 비용이나 조사 시간이 얼마나 줄어들지 계산할 수 없다. 보존 중인 데이터 양, 조회 이력과 계층별 요금이 필요하고, 수집과 검색 등 다른 비용 항목도 함께 계산해야 한다. AWS는 출시 시점에 바레인과 아랍에미리트의 중동 리전을 제외한 상용 리전에서 이 기능을 제공한다고 밝혔다. 실제로 적용 여부를 검토할 때에는 데이터를 둔 리전과 현재 계정에서 쓰는 로그 클래스를 먼저 확인할 수 있다.[1][2]
고정 클래스의 기능표와 저장 계층의 과금표를 섞어 보면 비용 눈금이 어긋날 수 있다. 가령 같은 양을 두 환경에 저장하더라도 하나는 최근 15일 기록을 자주 읽고 다른 하나는 오래된 기록까지 매달 거슬러 읽는다면 표준 계층에 머무는 범위가 달라질 수 있다. 이때 운영팀이 기록별 생성일만 집계하면 마지막으로 조회된 시점을 놓친다. 실제로 분류가 어떻게 달라지는지 비교하려면 조회된 기록의 범위와 저장내역을 함께 확인해야 한다. 2023년 옵션을 평가할 때는 기존에 필요한 로그 기능을 계속 쓸 수 있는지가 같은 정도로 중요하다.[1][2]