로그 안에 다른 형식이 겹쳐 들어오는 경우
AWS는 2026년 10월 14일 클라우드워치 파이프라인에서 조건부 로그 라우팅과 여러 파서를 차례로 연결하는 방식을 지원한다고 발표했다. 로그를 받으면 메시지 전체가 한 형식으로만 구성돼 있는 경우도 있지만, 바깥쪽 자료가 JSON이고 안쪽 메시지가 다른 형식의 문자열일 수 있다. 바깥 형식만 읽으면 메시지 전체를 문자열로 얻을 수 있어도, 안에 들어 있는 데이터의 항목은 바로 검색하거나 조건으로 쓰기 어려울 수 있다. [1][2]
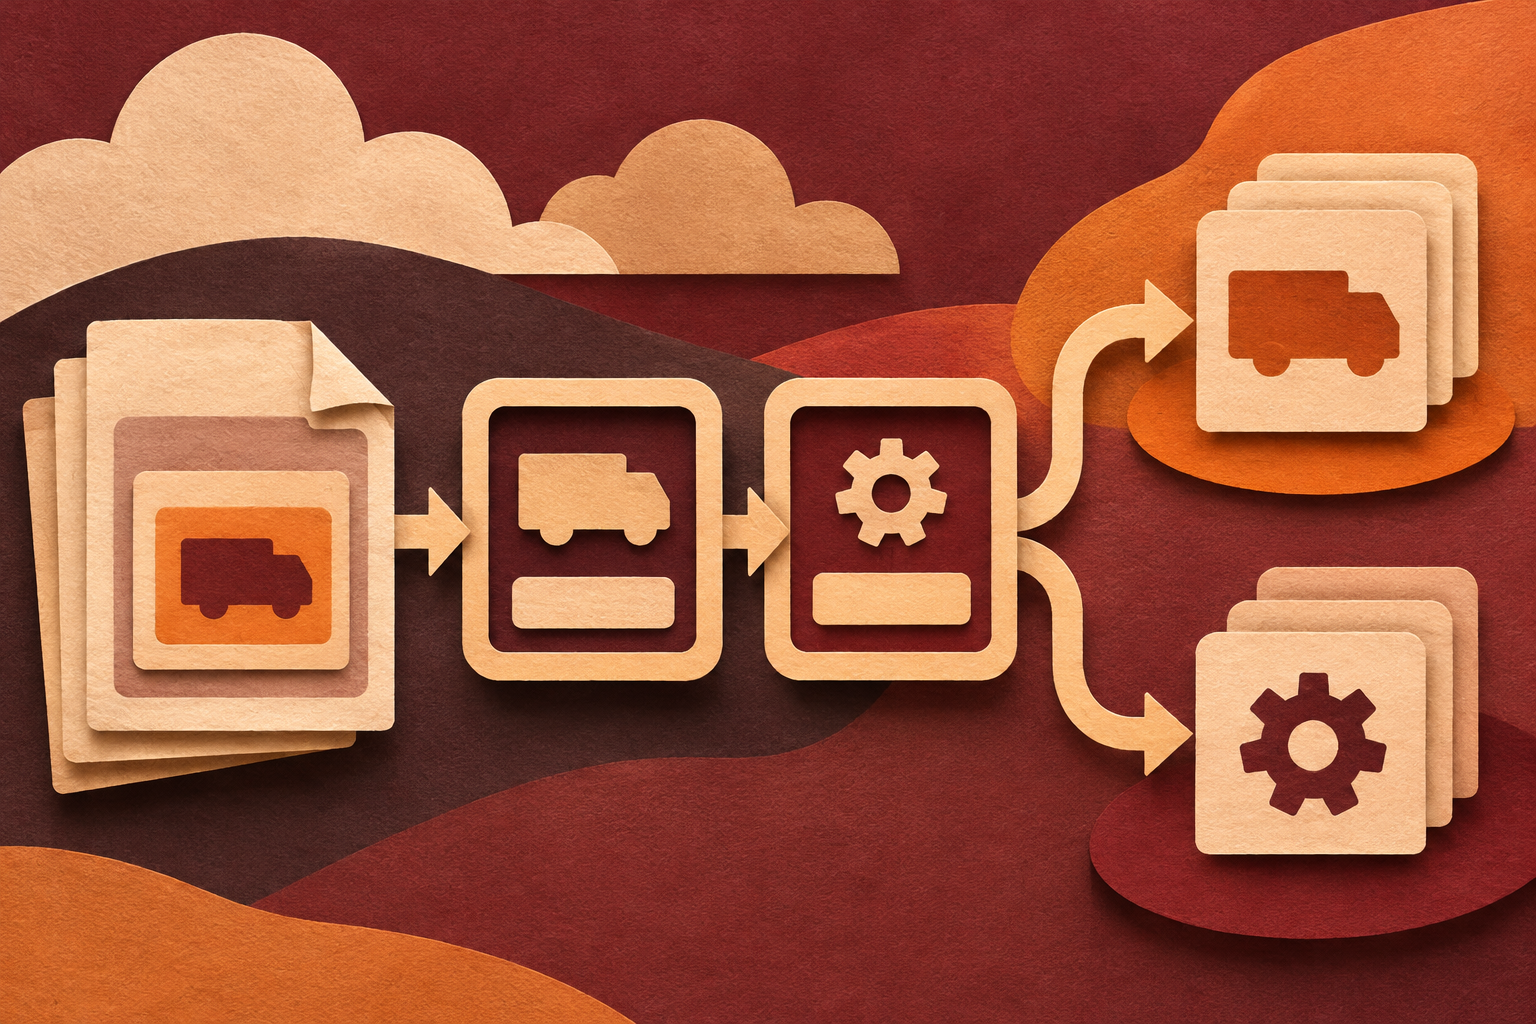
연속 파싱은 앞 단계가 만든 필드를 다음 파서의 입력으로 제공한다. AWS가 든 사례에서는 첫 단계가 JSON 형태의 외부 자료를 읽은 다음, 그 과정에서 꺼낸 문자열 필드에 별도의 패턴 파서를 적용한다. 단계별로 읽을 입력을 명확히 두면 원래 로그 형식이 중첩돼 있어도 검색이나 운영에 필요한 값을 별도 필드로 사용할 수 있다. 조건부 라우팅은 그렇게 처리한 값으로 보낼 로그 그룹을 정한다. [1]
같은 입력으로 받아도 서로 다른 곳에 보낼 수 있다
가령 배송 애플리케이션이 일반 진행 로그와 오류 이벤트를 같은 파이프라인에 전송한다고 하자. 바깥쪽 메시지에 서비스 식별자가 있고 안쪽 문자열에 처리 상태가 기록돼 있다면, 파서로 두 값을 읽은 뒤 필요한 오류 유형만 운영팀의 로그 그룹으로 보낼 수 있다. 평상시 진행 기록은 별도 그룹에 두는 방식이다. 예시에서 경로를 정하는 기준은 관리자가 선언한 조건이며 파이프라인이 알지 못하는 업무 의미를 스스로 알아내는 구조는 아니다. [1][2]
라우팅 결과를 정의할 때에는 어디서 온 데이터인지와 어느 조건에 걸릴지를 정리한다. 예를 들어 쓰기 작업이 끝난 상태를 나타내는 값과 데이터 처리 실패를 뜻하는 값을 구분해 두면, 운영팀이 보게 될 로그 그룹을 나눌 수 있다. 로그를 나눠 보관하면 운영 사례에 맞춰 각 저장 장소의 보존 기간이나 접근 관리 범위를 정하는 데 활용할 수 있다. 기존 권한 설정과 보존 정책은 그룹과 조직의 요구를 확인해 적용한다. [1]
8월의 처리기와 10월의 연결 기능
AWS는 8월 19일 같은 서비스에 RDS 로그, XML, 지리 정보 보강 처리기를 발표했다. XML 처리기는 문자열로 담긴 XML의 내용을 구조화하는 데, RDS 처리기는 특정 데이터베이스 로그를 검색할 수 있는 필드로 만드는 데 쓰인다. 각각의 처리기는 입력을 어떤 형식으로 해석할지 결정하는 도구다. 10월에 발표한 기능은 단계 사이의 입력과 출력을 연결하고 조건에 따라 최종 목적지를 나누는 흐름에 관한 것이다. [1][2]
하나의 처리기가 원하는 필드를 한 번에 얻는 경우에는 여러 단계를 연결할 필요가 없다. 이와 달리 처리하려는 문자열이 처음에는 바깥 자료 안에 감춰져 있다면 두 단계의 구분이 중요하다. 8월 공지가 처리기 선택을 넓혔다면, 10월 공지는 이미 구조화된 값을 다시 입력으로 사용하거나 목적지 조건에 넣는 방법을 보여 준다. 한 도구에서 운영할 수 있어도 파싱 결과와 그룹 선택은 각자 확인해야 할 결과다. [1][2]
파싱 실패와 경로의 영향
운영 로그는 새 버전에 따라 필드 이름이 바뀌거나 일부 행에서 값이 빠질 수 있다. 예를 들어 일반 로그와 오류 로그가 다르게 작성돼 같은 파서에서 한쪽만 구조화될 가능성도 있다. 파싱 후에 얻을 필드가 없으면 운영자가 정의한 경로가 의도대로 선택되지 않을 수 있다. 실제 적용에 앞서 구조화된 정상 로그 몇 건과 예상 형식에서 벗어난 로그를 함께 넣어 어디로 저장되는지 확인할 수 있다. [1][2]
어떤 로그를 어느 그룹에 보낼지와 저장 이후 누가 접근할 수 있는지는 별도 설정이다. 조건을 추가한다고 해서 모든 로그의 보관 기간이나 읽기 권한이 자동으로 정해지지는 않는다. 오래 보관해야 하는 항목만 따로 모으고 싶다면 먼저 조건에 해당하는 이벤트가 빠짐없이 도착하는지 살핀다. 원본 메시지를 보존할 필요가 있는지도 업무에 따라 판단할 수 있다. [1]
입력 형식이 바뀌면 조건도 다시 점검
파이프라인의 처음 단계에서 서비스 이름을 읽었다 해도 나중에 필요한 심각도나 상태 값이 다른 형식으로 들어오면 해당 값에 맞는 파서가 필요하다. 중첩 자료는 한 단계가 다른 단계에 제공한 입력이 어떤 형태인지 드러내는 것이 중요하다. 조직은 데이터 형식이 바뀔 때 어떤 단계에서 추출이 안 됐는지 확인하고 해당 필드를 쓰는 목적지 조건도 함께 살펴볼 수 있다. [1][2]
기존에 여러 형식이 섞인 로그를 모아 저장한 뒤 검색할 때마다 하나씩 변환하던 경우, 구조화 시점을 앞당기면 목적지 선택에 앞서 조건을 확인할 수 있다. 다만 어떤 필드로 분류할지와 모든 자료를 어느 기간 보관할지는 운영 정책에 따라 달라진다. 변환할 필드를 잘못 고르면 검색 대상에도 영향을 줄 수 있으므로, 결과에서 나뉜 그룹과 보존된 원본 항목을 각각 확인하면 된다. [1][2]
하나의 흐름에서 파서가 필요한 시점을 기록해 두면 개별 규칙이 어디에 영향을 주는지 찾기 쉽다. 8월의 XML 처리기는 정해진 형식 자체를 읽는 기능이고, 10월의 연속 파싱은 처리기가 만든 필드를 다음 단계로 넘기는 기능이다. 새 목적지로 보낼 수 있는 값도 실제로 추출됐는지 확인한 다음 분류 조건에 사용할 수 있다. [1][2]
발표의 지원 범위
AWS는 클라우드워치 파이프라인이 일반 제공되는 상용 AWS 리전에서 이 기능을 사용할 수 있다고 밝혔다. 10월 설명은 한 파이프라인에서 처리기들을 잇고 로그 그룹을 목적지로 정할 수 있음을 확인한다. 전체 로그 처리량과 비용, 원하는 필드의 추출률은 수집하는 데이터와 구성에 따라 달라질 수 있다. 새 기능을 적용할 때에는 로그의 바깥 형식과 안쪽 문자열, 조건에 필요한 필드와 그룹별 분류 결과부터 비교할 수 있다. [1][2]