구글은 2025년 6월 26일 5월 미리보기에 이어 Gemma 3n의 정식 공개와 개발자 안내를 발표했다. 이미지·오디오·비디오·텍스트 입력과 텍스트 출력을 지원하는 단말 중심 모델이며 E2B와 E4B 두 크기를 설명했다. 엔비디아도 같은 날 RTX와 Jetson에서의 지원을 공식 소개했다.[1][2]
이름의 2B·4B만 보고 전체 매개변수가 20억·40억이라고 읽으면 설계를 오해할 수 있다. 구글이 밝힌 전체 수는 각각 50억과 80억이다. 모델의 총규모, 가속기에 올려야 하는 핵심 부분, 실행에 필요한 전체 메모리는 같은 숫자가 아니다.[1]
일부를 다른 곳에서 처리해 부담을 줄인다
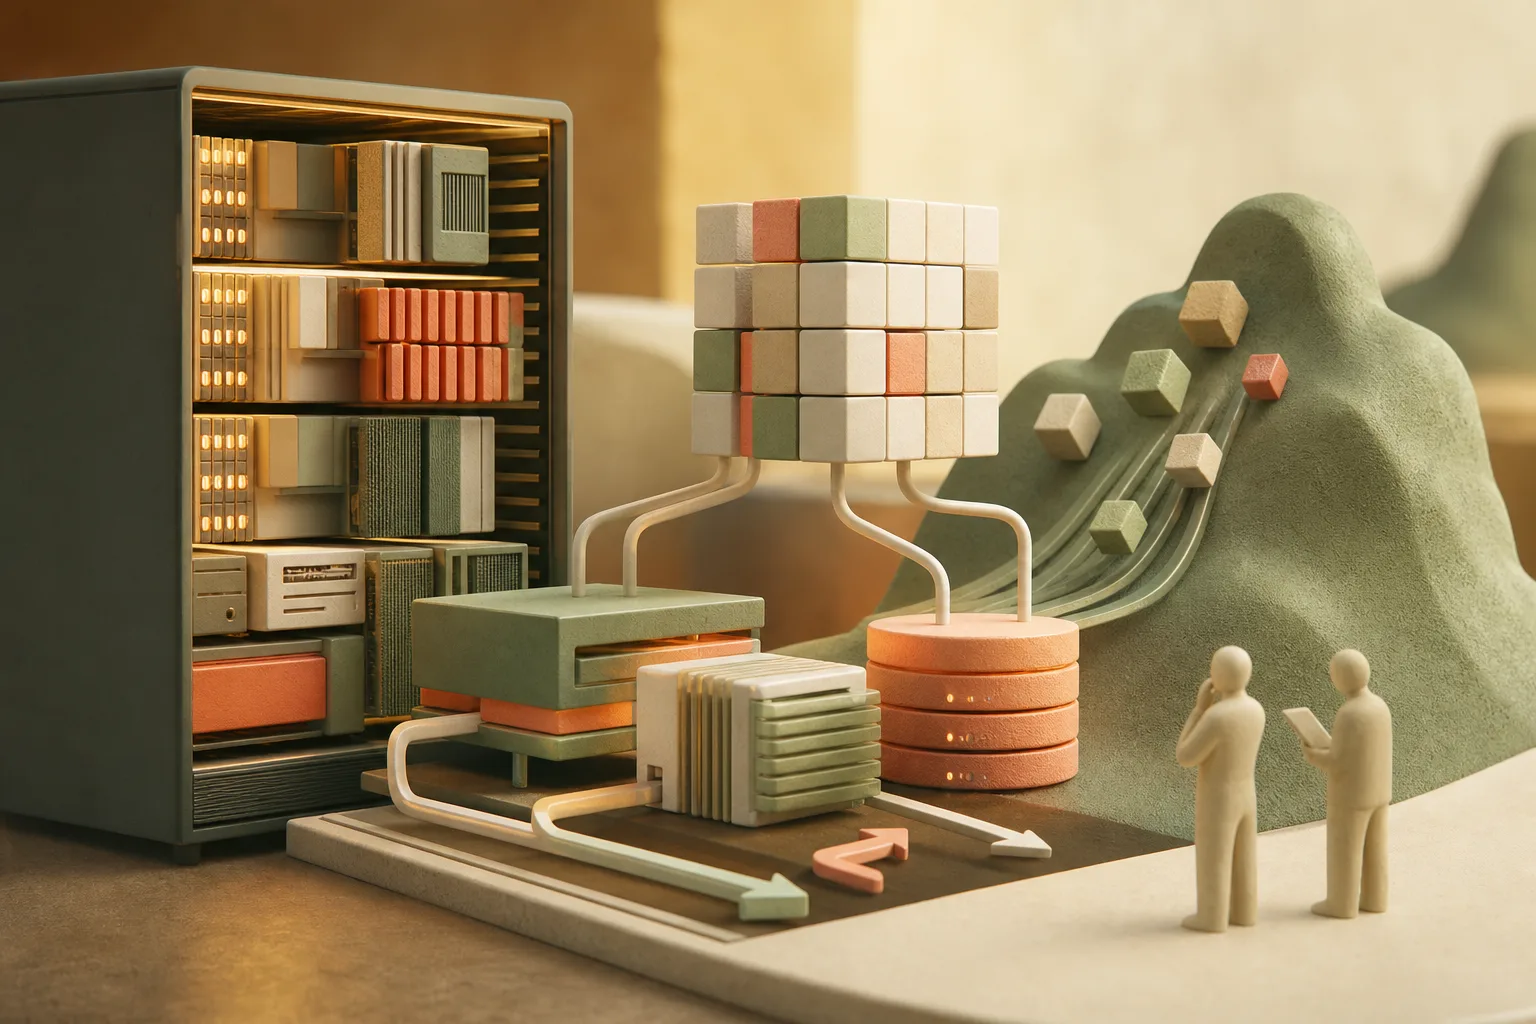
구글은 층별 임베딩(PLE)이라는 구조를 설명했다. 매개변수의 상당 부분을 CPU에서 효율적으로 불러와 계산하도록 해, 자원이 더 제한적인 가속기 메모리에 핵심 트랜스포머 가중치 위주로 둘 수 있다는 것이다. 전체 매개변수를 삭제한 것이 아니라 배치와 처리 방식으로 부담을 조절한다.[1]
엔비디아도 E4B의 전체 80억 매개변수와 전통적인 40억 규모 모델에 가까운 동적 메모리 부담을 구분했다. 두 발표는 같은 설계의 방향을 확인해 준다. 다만 저장 파일 크기와 가속기 메모리, 시스템 RAM은 서로 다른 항목이다. 하나의 낮은 수치를 모든 자원 요구량으로 바꿀 수는 없다.[2]
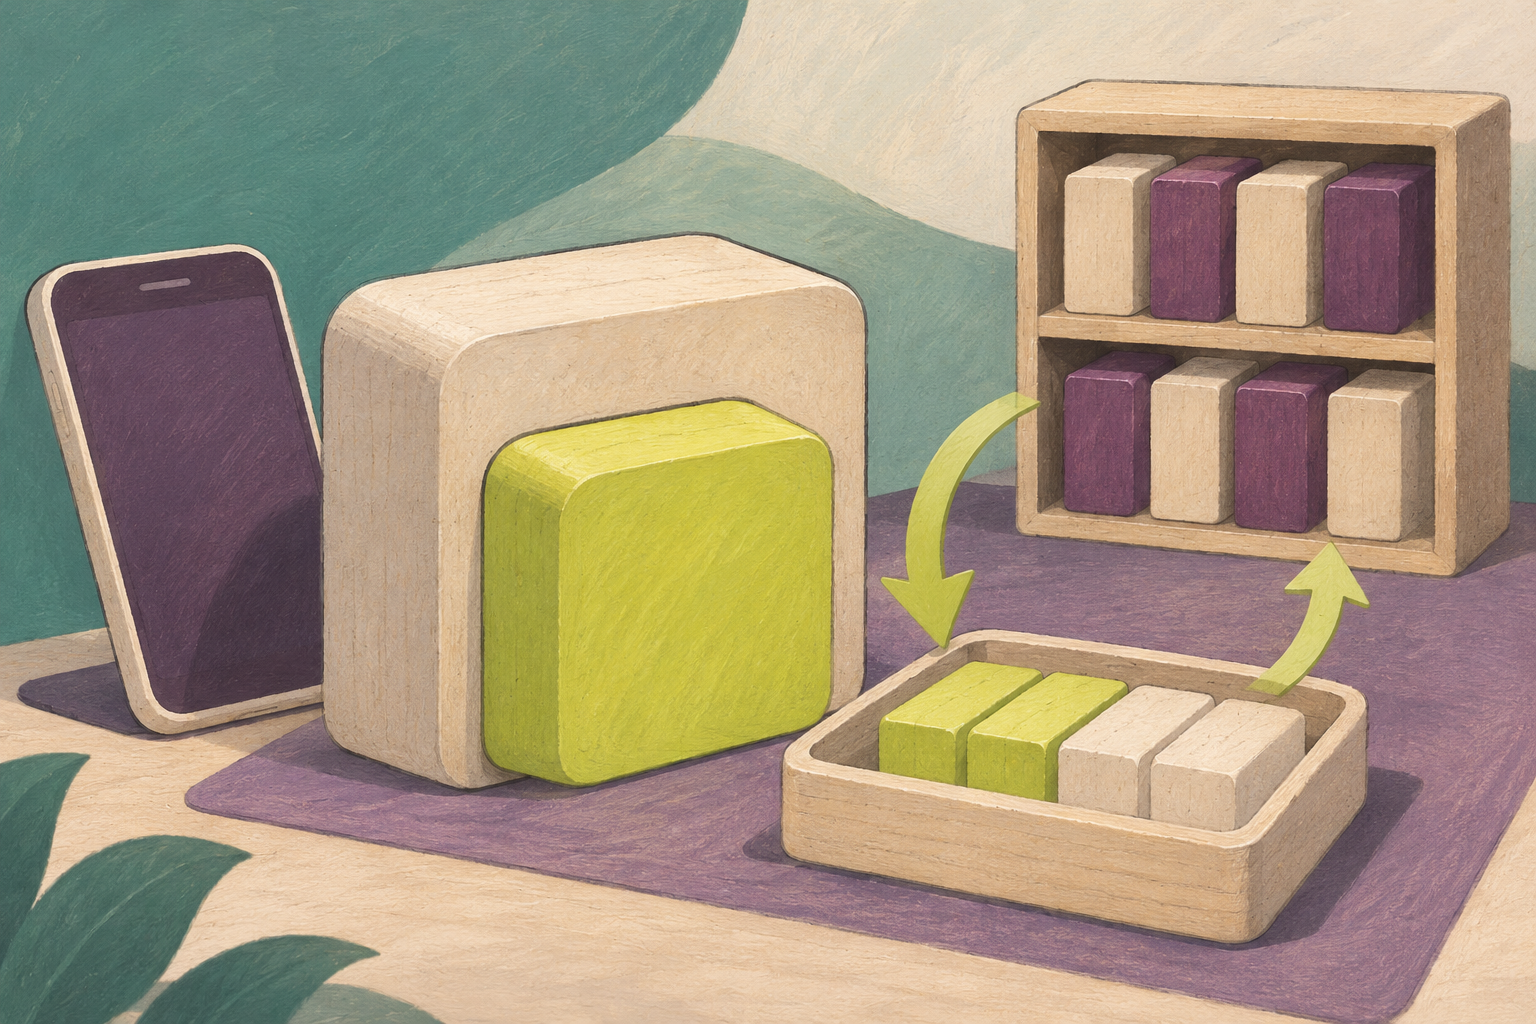
가정한 예시로 서가에 책 8권이 있어도 책상에는 지금 쓰는 4권만 놓을 수 있다. 그렇다고 책이 총 4권으로 줄어든 것은 아니다. 이 비유는 배치와 전체 규모를 구분할 뿐, 실제 매개변수의 이동 단위나 처리 속도를 정확히 재현하지 않는다. 소프트웨어 구현과 하드웨어별 추가 비용이 남는다.
작은 모델과 큰 모델을 함께 학습한다
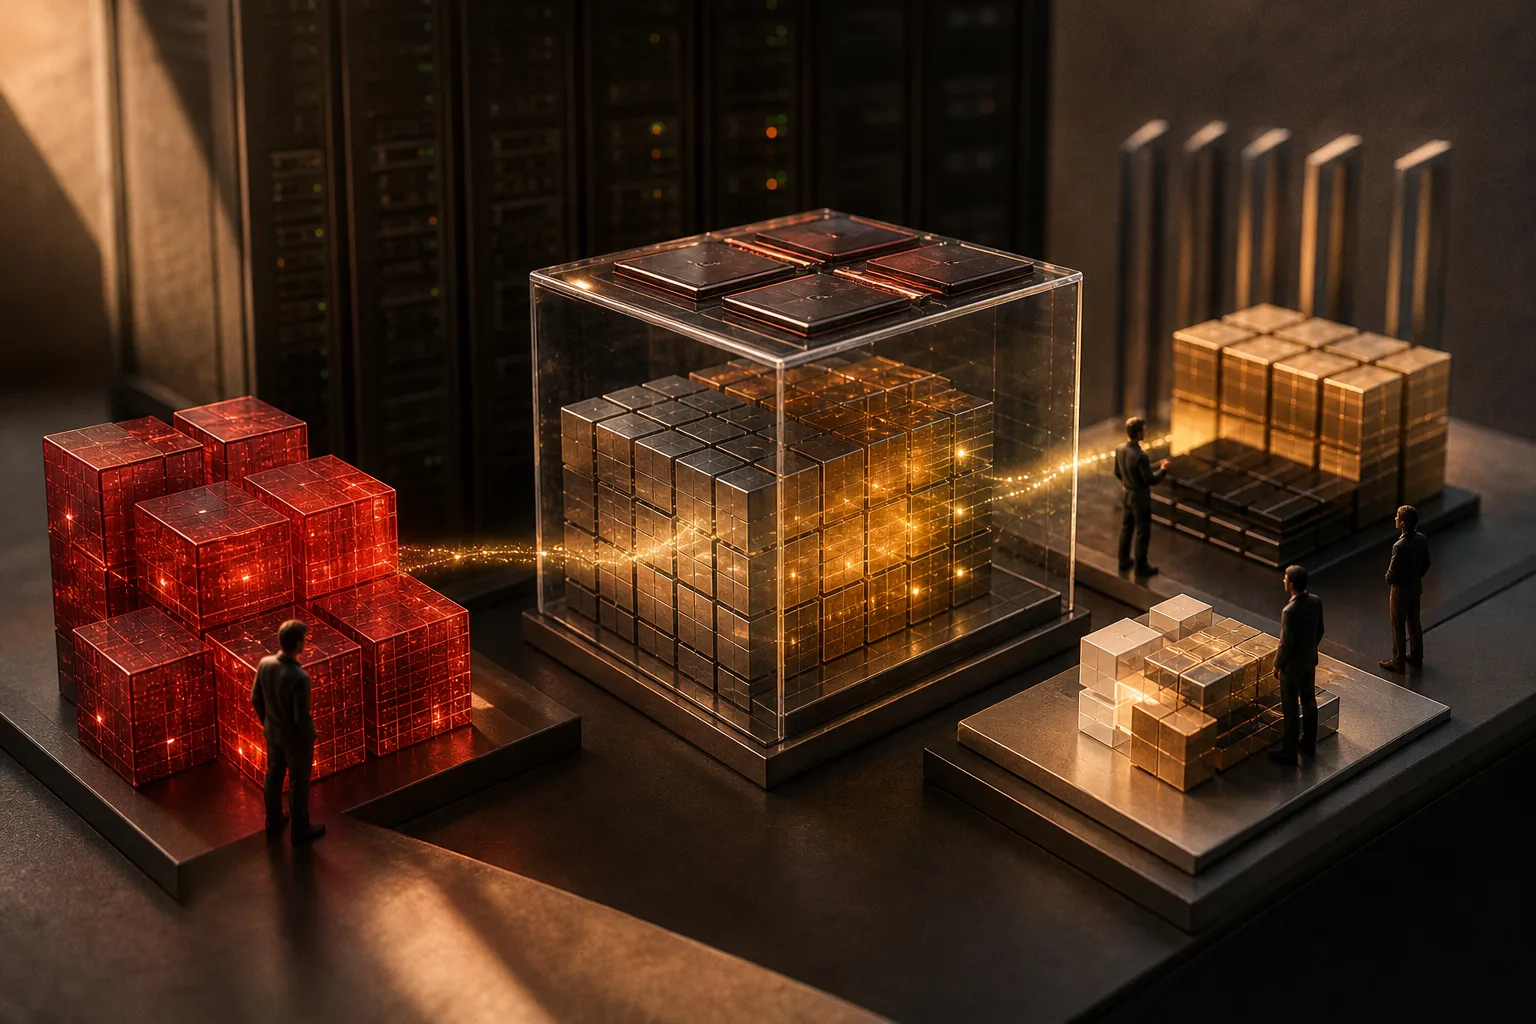
MatFormer는 큰 모델 안에 작지만 기능하는 모델을 중첩하는 구조다. 구글은 E4B 학습 과정에서 E2B 하위 모델을 함께 최적화했고, 개발자가 각각 추출된 E4B와 E2B를 직접 내려받아 쓸 수 있다고 설명했다. 목적에 맞춰 품질과 자원 사이의 선택을 하도록 한 방식이다.[1]
중간 크기의 모델을 만드는 Mix-n-Match 방법도 소개됐다. 층의 일부 구조 등을 조절해 하드웨어 조건에 맞는 크기를 만들 수 있다는 설명이다. 그러나 크기를 줄이면 모든 작업에서 품질이 그대로 유지된다고 보장한 것은 아니다. 목표 작업을 정하고 품질과 지연 시간을 함께 평가할 필요가 있다.
특히 실행 중 E4B와 E2B 경로를 즉석에서 바꾸는 탄력적 실행은 향후 가능성으로 설명됐다. 구글은 당일 출시 구현의 일부가 아니라고 명시했다. 구조가 앞으로 허용할 수 있는 기능과 지금 내려받아 사용할 수 있는 기능을 분리해야 공개의 실제 범위가 보인다.[1]
여러 입력과 출력의 방향
이번 정식 공개 안내는 이미지·오디오·비디오·텍스트를 입력으로 받아 텍스트를 출력한다고 설명했다. 사진이나 음성을 이해하는 기능과 이미지·음성 파일을 생성하는 기능은 다르다. 여러 종류의 정보를 다루는 모델이라는 표현에서 모든 형태의 생성 출력을 자동으로 끌어낼 수 없다.[1]
예를 들어 사진의 내용을 문장으로 설명하는 앱과 사진 자체를 새로 만드는 앱은 결과물의 유형이 다르다. 녹음의 말을 텍스트로 옮기는 작업과 새 음성을 합성하는 작업도 마찬가지다. 이 예시는 공개된 입출력 구분을 응용한 상황이며 별도의 앱을 실제 제작해 성능을 측정했다는 뜻은 아니다.
오디오 구현은 출시 시점에 최대 30초 클립을 처리하도록 돼 있다고 밝혔다. 바탕 인코더에 긴 스트리밍 처리를 위한 가능성이 있다는 설명과, 그 기능이 현재 구현에서 즉시 제공된다는 주장은 다르다. 긴 녹음을 넣을 때는 분할과 문맥 유지 등 실제 구현의 조건을 따로 확인해야 한다.[1]
단말 실행의 이점과 확인할 비용
기기 안에서 실행하면 입력을 원격 모델에 보내지 않고 처리하는 구성을 만들 수 있다. 그러나 모델을 내려받고 앱이 다른 서비스와 통신하는 과정까지 모두 자동으로 사라지는 것은 아니다. 오프라인 실행 가능성과 특정 앱의 모든 데이터 흐름이 오프라인이라는 주장은 구별된다.
엔비디아는 RTX와 Jetson에서 Ollama를 사용하는 경로와 자체 데이터에 맞추는 개발 도구를 소개했다. 이는 해당 플랫폼의 제공자가 제시한 지원 방법이다. 모든 휴대전화에서 같은 속도·전력 사용·메모리 요구량이 나온다는 독립 시험은 아니다. 실제 적용 판단에는 대상 기기의 측정이 필요하다.[2]
구글이 제시한 적은 메모리 사용 가능 수치는 최소 조건의 가능성을 설명한다. 앱 자체의 화면과 파일 처리, 긴 입력을 위한 캐시, 실행 환경의 다른 메모리도 필요할 수 있다. 모델 이름이나 매개변수 하나만으로 기기의 총 RAM 요구량과 배터리 지속 시간을 확정하면 설계 선택의 조건을 생략한다.
텍스트가 출력된다는 사실도 내용의 정확성을 보장하지는 않는다. 사진 설명이나 음성 전사가 실제 상황과 맞는지는 별도로 확인해야 한다. 단말 안에서 처리해 통신 의존을 줄이는 설계와, 모델이 틀린 설명을 만들지 않는다는 보장은 서로 다른 성능 조건이다.
이 기록은 2025년 6월 28일까지 공개된 구글 개발자 안내와 엔비디아 지원 발표를 대조했다. 모델을 직접 설치하거나 속도를 시험했다는 주장은 하지 않았다. 전체 매개변수와 메모리 배치, 입출력 방향, 현재 구현과 미래 가능성을 나누는 것이 이번 정식 공개를 이해하는 기준이다.