2026년 4월 16일 앤트로픽은 클로드 오퍼스 4.7을 공개했다. 이미지 입력에 대해 회사는 긴 변 기준 최대 2,576픽셀, 약 375만 픽셀 규모의 고해상도 이미지를 받을 수 있다고 설명했다. 모델이 이미지를 읽을 때 보존할 수 있는 세부 정보를 넓힌다는 취지다. 회사는 같은 텍스트도 새 방식으로 토큰을 나누면서 처리할 단위 수가 달라질 수 있다고 별도로 안내했다. [1]
긴 변과 이미지 전체 픽셀의 차이
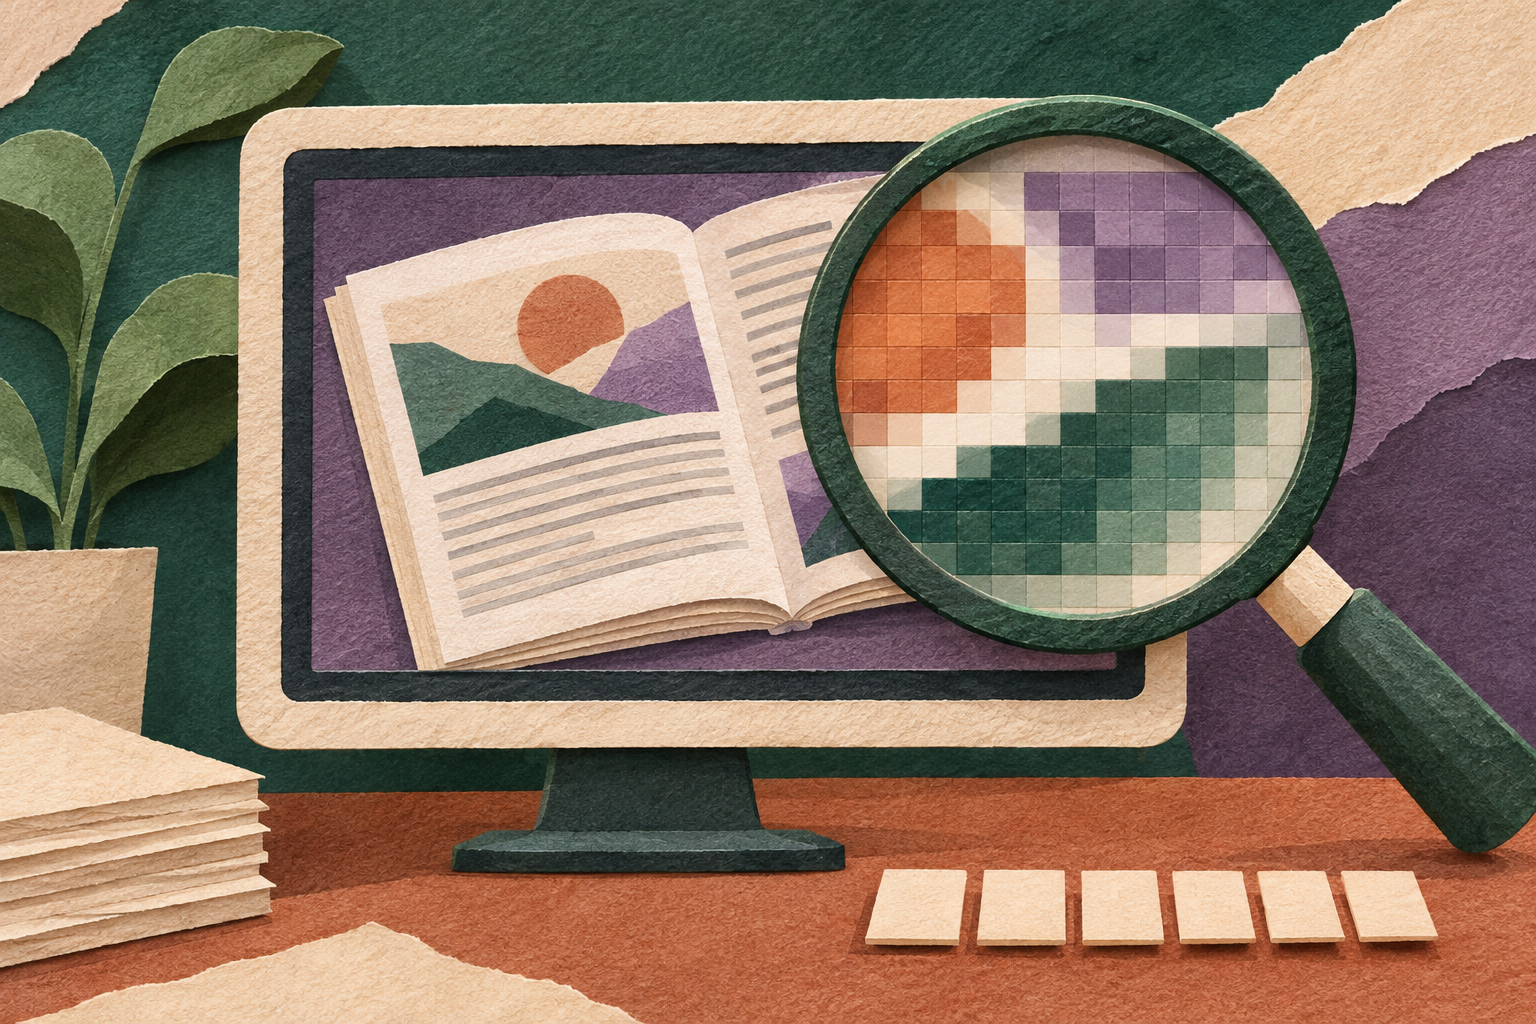
이미지의 해상도는 가로와 세로에 각각 몇 개의 픽셀이 들어가는지로 설명한다. 긴 변 수치는 가로와 세로 가운데 큰 쪽의 길이다. 전체 픽셀 수는 두 변을 곱해야 알 수 있다. 긴 변이 같더라도 세로가 짧은 배너와 화면에 가까운 비율의 문서는 전체 픽셀이 다르다. 회사가 밝힌 최대 긴 변이나 대표 픽셀 규모만으로 모든 가로세로 비율에서 같은 픽셀 수를 처리한다고 추정하기는 어렵다. [1]
가령 1,600×900픽셀인 이미지는 144만 픽셀로 구성된다. 같은 비율로 늘린 2,400×1,350픽셀 이미지는 324만 픽셀이다. 변마다 1.5배가 되지만 전체 픽셀은 2.25배가 된다. 두 이미지의 해상도 차이를 설명하는 예다. 낮은 해상도의 원본을 단순히 크게 확대했다고 원래 없던 글자 정보까지 복구되는 것은 아니다.
전작이 발표한 문맥 길이와 비교
2월 5일 오퍼스 4.6 발표에서 앤트로픽은 개발자 플랫폼의 베타 기능으로 100만 토큰 문맥 길이를 소개했다. 4월 16일 오퍼스 4.7 발표에서는 이미지의 긴 변 최대 2,576픽셀과 높은 해상도의 시각 입력을 별도로 설명했다. 문맥 길이는 모델이 하나의 요청에서 참고할 여러 자료의 규모를 읽는 기준이고, 이미지 해상도는 개별 화면의 형태와 세부 수준에 관한 기준이다. 단위가 다르므로 하나가 커졌다는 발표에서 다른 조건이 같은 정도로 늘었다고 계산할 수 없다. [2][1]
예를 들어 여러 쪽의 텍스트만 있는 설명서를 읽는 작업과 글자 크기가 작은 화면 캡처를 확인하는 작업에서 필요한 정보가 다르다. 설명서에서는 한 번에 몇 쪽의 문장을 함께 참고할 수 있는지가 중요한 경우가 있다. 화면 캡처에서는 한 그림 안의 글자 크기와 대비, 잘린 부분이 있는지가 영향을 준다. 두 기능을 비교할 때는 어떤 파일이나 작업에 사용하려는지 기준부터 정해야 실제 차이를 알 수 있다.
문서가 길다는 표현도 두 가지 의미로 쓸 수 있다. 같은 이미지 해상도로 된 페이지가 수십 장인 책은 한 페이지의 해상도가 낮지 않아도 전체 입력량이 많다. 반대로 한 장으로 된 큰 도표는 문서의 쪽수가 적지만 그림 내부의 작은 글자와 선을 읽어야 한다. 페이지 수와 개별 이미지 해상도를 각각 확인해야 입력 자료의 어느 부분에서 개선을 체감할지 판단할 수 있다. [1][2]
새 토큰 분할 방식에서 달라질 수 있는 비용 단위
모델이 입력을 처리할 때 텍스트는 여러 덩어리로 나뉜다. 이 단위를 토큰이라 부른다. 앤트로픽은 오퍼스 4.7이 다른 토큰 분할 방식을 사용하기 때문에 같은 입력도 콘텐츠에 따라 전작의 약 1.0~1.35배로 나뉠 수 있다고 밝혔다. 원문에 같은 글자 수가 적혀 있어도 모델에 전달되는 계산 단위와 사용량의 측정값은 달라질 수 있는 셈이다. [1]
가령 같은 텍스트가 전작에서 1,000토큰이었다면, 회사 설명의 범위를 단순 적용했을 때 다른 버전에서는 약 1,000~1,350토큰이 될 수 있다. 이 예시는 이용량 단위가 움직이는 방식을 설명한다. 특정 파일에서 실제로 몇 토큰이 되는지, 전체 요청 비용이 얼마나 되는지는 사용하는 방식과 출력 분량 등을 별도로 확인해야 한다. 고해상도 이미지가 들어오는 경우 텍스트만의 예상으로 총 입력량을 계산하는 것도 조심해야 한다. [1][2]
텍스트 토큰이 더 많이 생기면 입력의 사용량을 예측할 때 과거 측정치에서 다시 계산해야 할 수 있다. 이전 모델에서 파일 여러 개를 읽을 때와 같은 문서로 시험하되 새 모델이 보고하는 입력과 출력 단위를 확인하는 방식이다. 같은 글을 분석해도 글자의 종류나 언어에 따라 토큰의 수가 달라질 수 있어, 한 파일에서 나온 배율을 모든 파일에 똑같이 적용하기 어렵다. [1]
이미지 평가에도 입력과 출력에 다른 조건이 있다. 더 큰 이미지가 모델에 들어갔다는 사실은 모델이 요청한 표의 각 항목을 정확하게 짚었다는 결과와 다르다. 실무 자료에서 읽어야 할 셀이나 주석의 정답을 미리 뽑아 두면 두 버전이 같은 자료에서 어떤 내용을 놓쳤는지 구분할 수 있다. 픽셀 수와 정확도를 각각 기록하면 한 종류의 수치를 다른 종류의 성능으로 사용하는 일을 피할 수 있다. [1][2]
공개 자료에서 확인한 것과 실제 활용
4월 발표만으로는 특정 도표나 문서에서 더 높은 입력 해상도가 인식 오류를 얼마나 줄일지 확정하기 어렵다. 사진의 품질과 글자의 배치가 달라지면 같은 입력 크기라도 결과가 다를 수 있다. 원본이 선명한지 확인한 뒤 같은 자료로 그림 읽기와 긴 문서의 내용을 확인하는 작업을 각각 비교할 수 있다. 공개 자료에서 확인된 것은 회사가 발표한 입력 크기, 문맥 길이와 토큰 사용 조건이다. [1][2]
고해상도 문서 이미지에 작은 글자가 많이 있는 경우에도 읽어야 할 항목을 지정하는 방식이나 출력의 확인 절차가 결과에 영향을 줄 수 있다. 모델이 받는 이미지 크기만을 기준으로 문서의 사실을 얼마나 잘 이해했다고 말하기에는 정보가 부족하다. 서로 다른 조건을 비교하고 싶다면 화면 크기, 문서 범위와 측정하려는 작업을 기록해 같은 입력으로 결과를 확인한다. [1]