2026년 4월 22일 구글 클라우드는 연례 행사에서 AI 연산용 8세대 TPU 두 종류를 발표했다. TPU는 구글이 개발한 텐서 처리 장치다. 회사는 TPU 8t를 대규모 사전학습용으로, TPU 8i를 추론과 강화학습을 포함한 후속 학습용으로 설계했다고 설명했다. 차이는 한 칩의 연산 능력에만 있지 않다. 칩 여러 개가 연결되는 방법과 중간 계산 결과를 전달하는 경로가 제품별로 달라졌다. [1] [3]
사전학습에 필요한 연속적인 데이터 처리
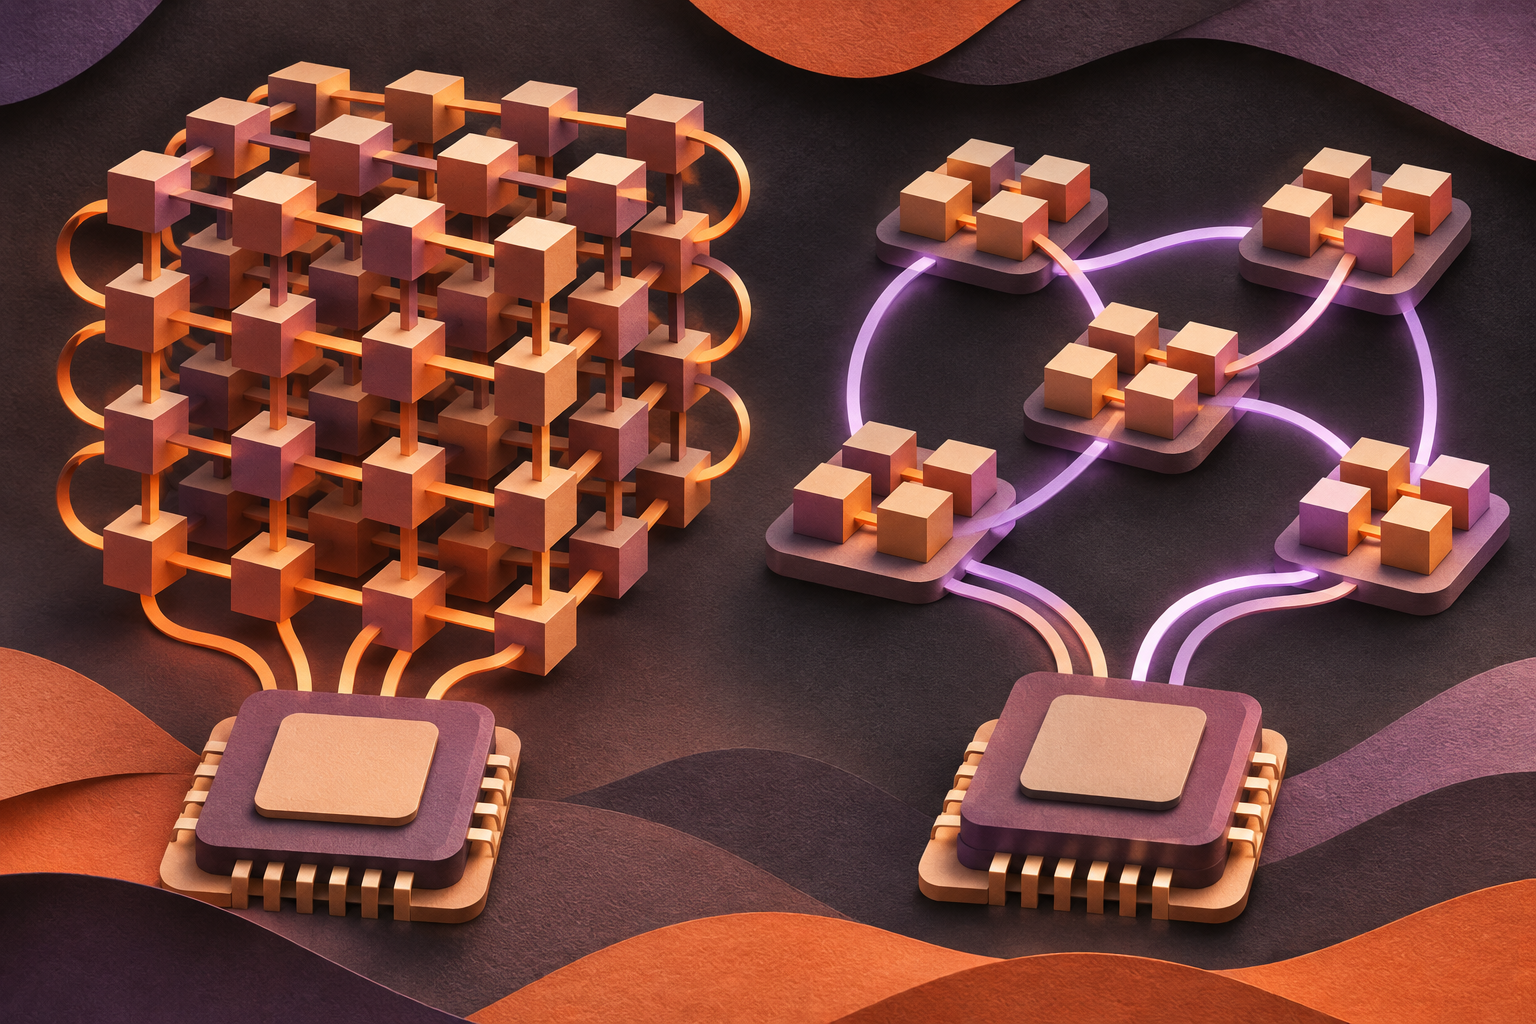
사전학습에서는 여러 칩으로 나눠 모델을 계산한 뒤 각 칩이 얻은 값을 주고받고 매개변수를 반복해서 조정한다. 계산할 데이터가 많으므로 한 번의 통신 지연에 더해 장시간에 걸쳐 얼마나 많은 데이터를 안정적으로 처리하는지가 걸린다. TPU 8t의 3차원 토러스는 칩들을 3차원 격자에 배치하고 각 축의 끝을 맞은편 끝과 연결한 네트워크다. 이웃과 데이터를 교환하는 일정한 작업에 이런 배열을 쓸 수 있다. [1]
구글은 TPU 8t의 단일 슈퍼팟에 최대 9,600개 칩을 연결하는 구성을 공개했다. 사전학습 데이터를 읽어 오는 경로를 개선하는 기술도 공개했다. 외부 저장장치나 다른 장비에서 데이터가 너무 늦게 들어오면, 충분한 계산 장치를 갖추고도 입력을 기다리느라 일부 시간이 비게 된다. 사전학습 속도를 볼 때에는 칩의 연산 속도 외에 이런 저장장치와 네트워크의 공급 능력도 함께 고려해야 한다. [1] [3]
추론에선 요청 하나가 거치는 통신 경로가 중요하다
가령 같은 AI 서비스가 새 언어 모델을 보름 동안 학습하고 그 모델로 사용자 질문에 답한다고 하자. 학습을 맡은 시스템은 여러 계산 단계에서 많은 데이터를 반복적으로 교환한다. 답변 시스템은 첫 단어 이후의 단어를 차례로 생성하는 중에도 다른 칩에 있는 계산 결과를 기다릴 수 있다. 사용자 요청을 수십 개나 수백 개 동시에 받을 때 어느 일부 요청의 응답이 길어지는지까지 따져야 서비스 지연을 설명할 수 있다.
TPU 8i는 보드의 칩을 여러 묶음으로 묶은 뒤 묶음 사이를 광 스위치로 잇는 Boardfly를 사용한다. 칩 소그룹 내부는 짧은 연결로 묶고, 멀리 떨어진 목적지에는 다른 그룹으로 갈 수 있는 연결을 둔다. 특정 입력마다 여러 전문 모듈 중 일부를 선택하는 전문가 혼합 모델에서는 토큰이 서로 다른 장치에 흩어진 모듈로 이동할 수 있다. 연결 경로를 설계할 때 그런 모델의 통신 패턴이 중요해진다. [1]
구글 문서는 칩 1,024개를 놓은 같은 규모의 가정에서, 3차원 토러스의 가장 먼 경로가 16회 중계이고 Boardfly의 네트워크 지름은 7회라고 비교했다. 이 값은 칩 사이 경로가 몇 번의 연결을 거칠 수 있는지를 나타낸다. 사용자 화면에서 답변이 표시되기까지 걸리는 전체 시간을 16과 7의 비율로 낮춘다는 계산은 할 수 없다. 메시지 크기, 병목 위치와 애플리케이션 대기 시간까지 더해져야 하기 때문이다. [1]
7세대 아이언우드와 달라진 선택지
2025년 11월 공개 글에서 구글은 7세대 아이언우드를 높은 요청량과 짧은 지연이 필요한 추론 및 모델 서비스에 쓰는 장치로 소개했다. 같은 칩을 학습에도 활용하는 설명이 함께 있었다. 8세대 발표에서는 사전학습과 후속 학습·실시간 추론의 요구를 나누어 두 종류의 시스템을 제시했다. 학습과 추론이 모두 AI 연산을 쓰더라도 장비가 기다리는 데이터의 양과 통신 경로가 다르다는 점이 제품 구분에 반영됐다. [1] [2]
TPU 8i는 칩 안에 있는 SRAM의 용량도 키웠다. 회사는 이미 처리한 토큰의 정보를 임시로 보관하는 KV 캐시를 칩 내부에 더 많이 두려는 설계라고 설명했다. 입력이나 대화가 길어질수록 저장할 상태가 많아질 수 있다. 같은 정보를 가까운 메모리에서 꺼낼 수 있으면 계산 칩이 정보를 요청하고 응답을 받는 데 쓰는 시간을 줄일 여지가 생긴다. [1] [3]
같은 수의 토큰을 처리하는 경우에도 학습에서 한꺼번에 데이터를 계산하는 단계와 추론에서 새 토큰을 하나씩 이어 쓰는 단계의 대기 시간이 다르게 나타난다. 후자에서는 중간 결과를 받기 전 다음 계산을 할 수 없는 구간이 반복된다. 구글이 TPU 8i에서 여러 연산 장치의 결과를 합치는 전용 회로를 마련했다고 설명한 배경도 여기에 있다. 개선이 걸리는 부분은 주로 칩 내부에서 결과를 취합하고 계산 시점을 맞추는 과정이다. [1]
반대로 새 모델을 처음부터 학습하는 운영팀에는 데이터 묶음이 멈추지 않고 들어오는지가 중요하다. 몇 번의 개별 작업에서 보이는 최대 속도가 같아도, 전체 작업에서 장비가 유휴 상태로 기다리는 시간이 적으면 같은 기간에 더 많은 학습 단계를 마칠 수 있다. 제품 발표에서 네트워크와 저장 연결이 사양의 큰 부분을 차지한 이유다. [1] [3]
공개 사양으로 판단할 수 있는 범위
하드웨어 사양표만으로는 특정 서비스의 비용과 평균 응답 시간 또는 가장 느린 요청의 시간을 확정하기 어렵다. 비교하려면 모델 규모, 입력 길이, 동시에 처리하는 요청 수와 칩에 일을 배분하는 소프트웨어 조건을 맞춰야 한다. 8t의 단일 슈퍼팟 규모와 8i의 토큰 처리 성격을 같은 순위표에 놓고 어느 쪽이 항상 우월하다고 결론 낼 수 없는 이유다. [1]
발표에서 구글은 두 시스템을 클라우드 고객에게 곧 제공하겠다고 밝혔다. 당시 확인할 수 있는 정보는 두 종류를 공개했다는 사실과 업무에 따라 달라진 연결 구조다. 실제 AI 서비스의 응답 시간을 비교하려면 제품별로 같은 모델과 요청 조건에서 얻은 운영 측정치까지 필요하다. [3]