발표에서 함께 소개한 두 종류의 계산
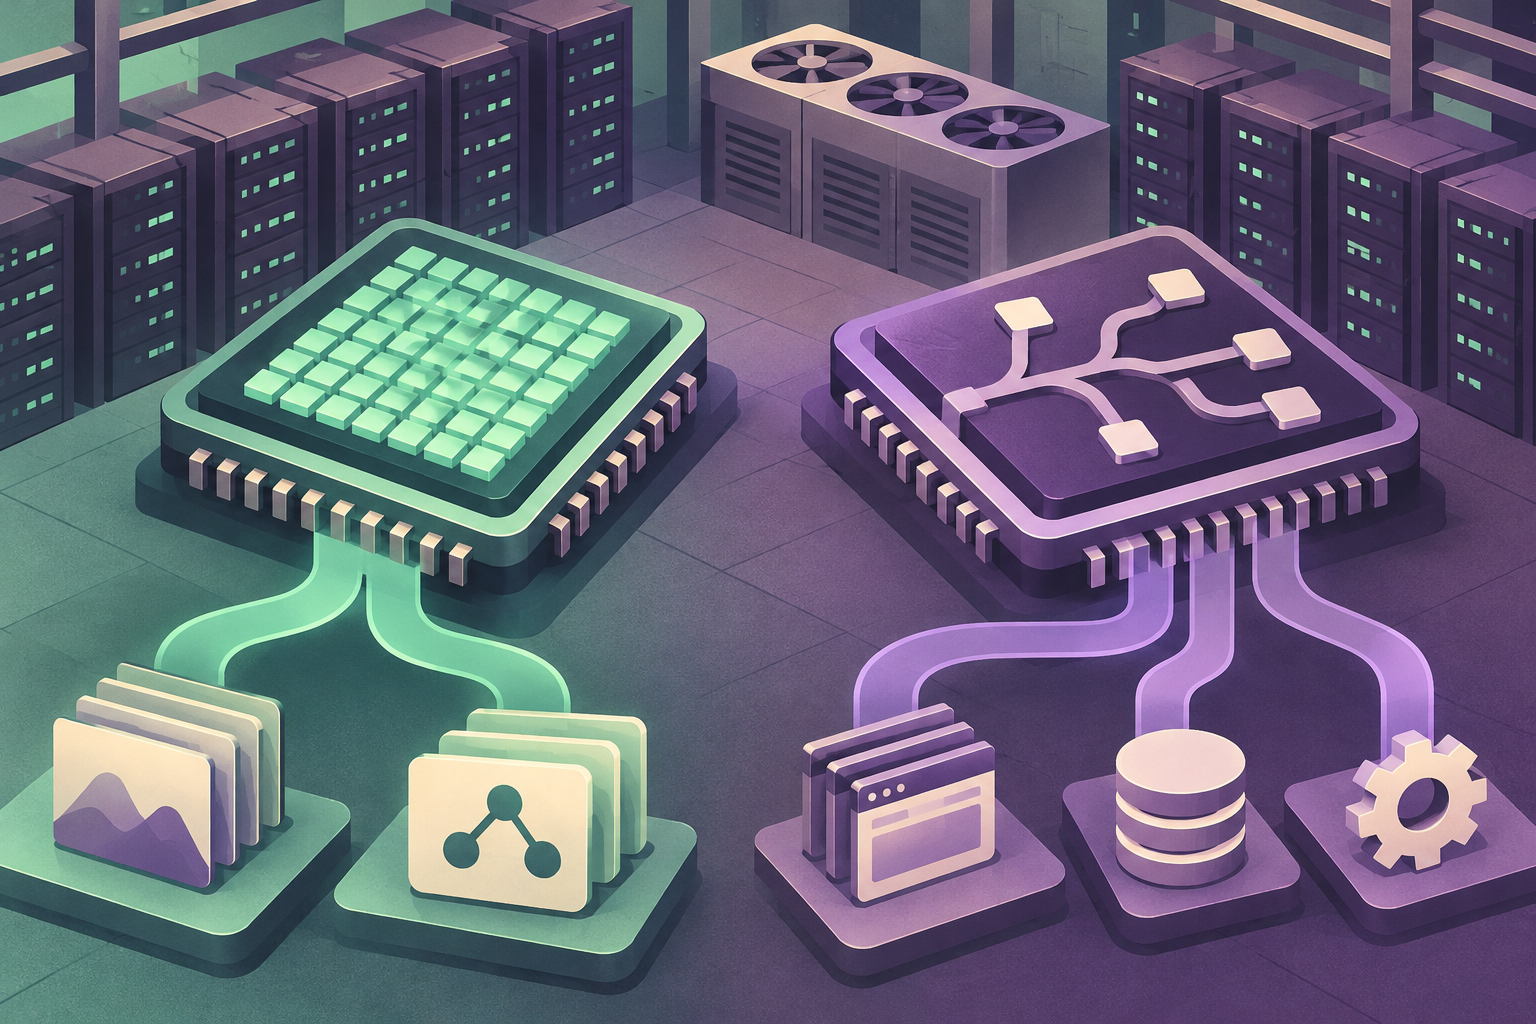
마이크로소프트는 2023년 11월 15일 이그나이트에서 애저 마이아 100과 애저 코발트 100을 공개했다. 둘 다 회사가 클라우드 데이터센터에 쓰도록 설계한 칩이지만 목표가 달랐다. 마이아 100은 AI 모델의 학습과 추론을 위한 가속기였다. 코발트 100은 범용 클라우드 작업을 처리하는 Arm 기반 중앙처리장치였다. 같은 날 공개됐어도 둘 사이에서 하나를 고르는 소비자용 제품 발표로 읽으면 각 칩의 역할을 놓치게 된다. [1][2]
회사는 이 두 칩을 따로 작동하는 부품 소개에 그치지 않고 서버와 데이터센터 설계의 일부로 설명했다. 계산을 빠르게 처리하더라도 서버 여러 대가 서로 데이터를 주고받거나 열을 빼내는 과정에서 병목이 생길 수 있기 때문이다. 당시 발표는 칩, 서버 보드, 랙과 냉각 등 주변 구성의 설계를 함께 언급했다. 칩의 역할을 살피는 것과, 칩을 넣은 서비스의 처리량을 판단하는 것은 그래서 별개의 문제다. [1][2]
학습과 추론은 같은 모델의 다른 작업이다
학습은 많은 예제를 처리하면서 모델이 사용할 내부 값을 조정하는 과정이다. 추론은 그렇게 정해진 값을 사용해 새 입력에 대한 결과를 계산하는 과정이다. 둘 다 여러 숫자에 비슷한 연산을 반복하는 부분이 있어, 한 번에 많은 연산을 다루도록 만든 가속기를 쓸 수 있다. 하지만 학습은 모델의 값을 바꾸고, 추론은 서비스를 쓰는 사람이 보낸 요청에 답하는 데 주로 쓰인다는 차이가 있다. 마이아의 발표 범위에는 두 작업이 모두 포함됐다. [1][2]
예를 들어 문장을 분류하는 서비스를 가정하면, 이미 분류가 붙어 있는 문장을 보고 모델을 만드는 일은 학습에 가깝다. 만들어진 모델에 새 문장을 넣고 분류 결과를 받는 일은 추론이다. 두 단계가 같은 칩 종류에서 실행될 수 있어도 필요한 메모리 크기와 데이터를 주고받는 양, 응답을 기다릴 수 있는 시간은 다를 수 있다. 한 종류의 작업에서 얻은 처리량 수치를 다른 종류의 작업에 그대로 옮기기 어려운 이유다. [1][2]
범용 CPU가 맡는 일이 따로 있다
웹 서비스에는 모델의 숫자 계산뿐 아니라 요청을 받아 어디로 보낼지 정하고, 프로그램을 실행하고, 저장소에 연결하는 일도 있다. 범용 CPU는 다양한 명령을 받아 운영체제와 여러 종류의 프로그램을 돌리는 데 맞는다. 코발트는 이런 일반적인 클라우드 작업을 위한 Arm 기반 CPU라는 설명과 함께 소개됐다. Arm은 프로세서가 이해하는 명령과 설계 계열을 가리키는 맥락에서 쓰인 말이며, 특정 AI 모델의 이름이 아니다. [1][2]
예를 들어 고객이 웹 화면에 글을 입력하면 한 서버가 접속을 관리하고 요청을 대기열에 놓을 수 있다. 모델을 실행하는 가속기가 분류를 계산하면 다른 서버가 그 결과를 저장해 화면에 돌려준다. 이는 두 종류의 계산이 같은 서비스 안에 있을 수 있음을 보여 주는 예이며, 당시 애저가 특정 서비스에 이 배치를 사용했다는 뜻은 아니다. 모델 계산만 빨라져도 접속 처리나 데이터 전송이 더 오래 걸리는 상황에서는 고객이 느끼는 대기 시간이 같은 폭으로 줄지 않는다. [1][2]
칩 발표와 서비스 제공 사이에는 차이가 있다
당시 발표에서는 새 칩을 데이터센터에 단계적으로 들여오는 방향을 설명했다. 어떤 작업에 맞는 칩인지 발표한 것과 특정 고객이 그날부터 해당 칩을 원하는 방식으로 선택할 수 있게 됐다는 것은 다르다. 또한 회사가 기존 공급업체의 시스템과 함께 새로운 설계를 소개한 만큼, 두 칩을 공개했다는 사실만으로 기존 칩의 사용을 중단했다거나 모든 클라우드 작업을 옮겼다고 볼 근거는 없다. 실제 도입 여부는 지원 서비스와 지역, 배치 시점에 따라 달라진다. [1][2]
성능을 평가하려면 처리한 모델이나 프로그램, 요청의 크기, 동시에 받은 요청 수, 전력과 시간의 측정 범위를 맞춰야 한다. 학습 시간을 비교하는 실험과 한 번의 추론 응답 시간을 재는 실험은 같은 질문에 답하지 않는다. 11월 발표는 어디에 맞춰 설계했는지를 보여 주는 출발점이다. 그날의 제품 이름이나 설계 설명만으로 다른 칩보다 어느 작업에서 얼마나 빠르고 저렴한지를 정할 수는 없다. [1][2]
이 구분이 중요한 이유는 AI 서비스 비용에 모델 연산 밖의 비용도 들어가기 때문이다. 모델을 한번 실행하는 데 드는 계산이 줄어도 데이터를 저장하거나 읽는 방식과 서버가 대기하는 시간은 그대로일 수 있다. 반대로 일반 작업의 전력 사용이 개선되더라도 모델 계산 자체의 처리량은 따로 재야 한다. 이그나이트 발표에서 AI 가속기와 범용 CPU가 나란히 나온 것은 클라우드의 이런 서로 다른 부담을 각각 다루려는 설계 방향을 보여 줬다. [1][2]
가속기와 CPU를 구별하는 것은 무엇을 측정해야 하는지도 알려 준다. 예컨대 응답 한 건의 대기 시간이 길다면 모델을 실행한 시간과 요청이 대기열에 머문 시간을 따로 기록할 수 있다. 앞의 시간이 크다면 가속기에서 처리한 계산을 살펴볼 근거가 되고, 뒤의 시간이 길다면 요청을 나누는 방식이나 서버 배치가 더 중요한 문제일 수 있다. 두 칩이 함께 소개됐다는 사실은 이처럼 서비스를 이루는 일이 하나가 아님을 이해하는 데 도움이 된다. 실제 성능 결론은 각 작업을 어떤 조건에서 쟀는지 확인한 뒤에 내릴 수 있다. [1][2]